計画、実装、レビューでは、モデルによって得意な進め方が異なります。別々のツールに分かれたままでは、ひとつの目標に向かって協力しにくい。AgentLoom はそこから出発し、利用上限、文脈の継続、席を離れたときの操作にも取り組んでいます。コーディングは、より幅広い仕事を扱うワークスペースの最初の実践の場です。
01 / 仕事に合わせてモデルを選ぶ
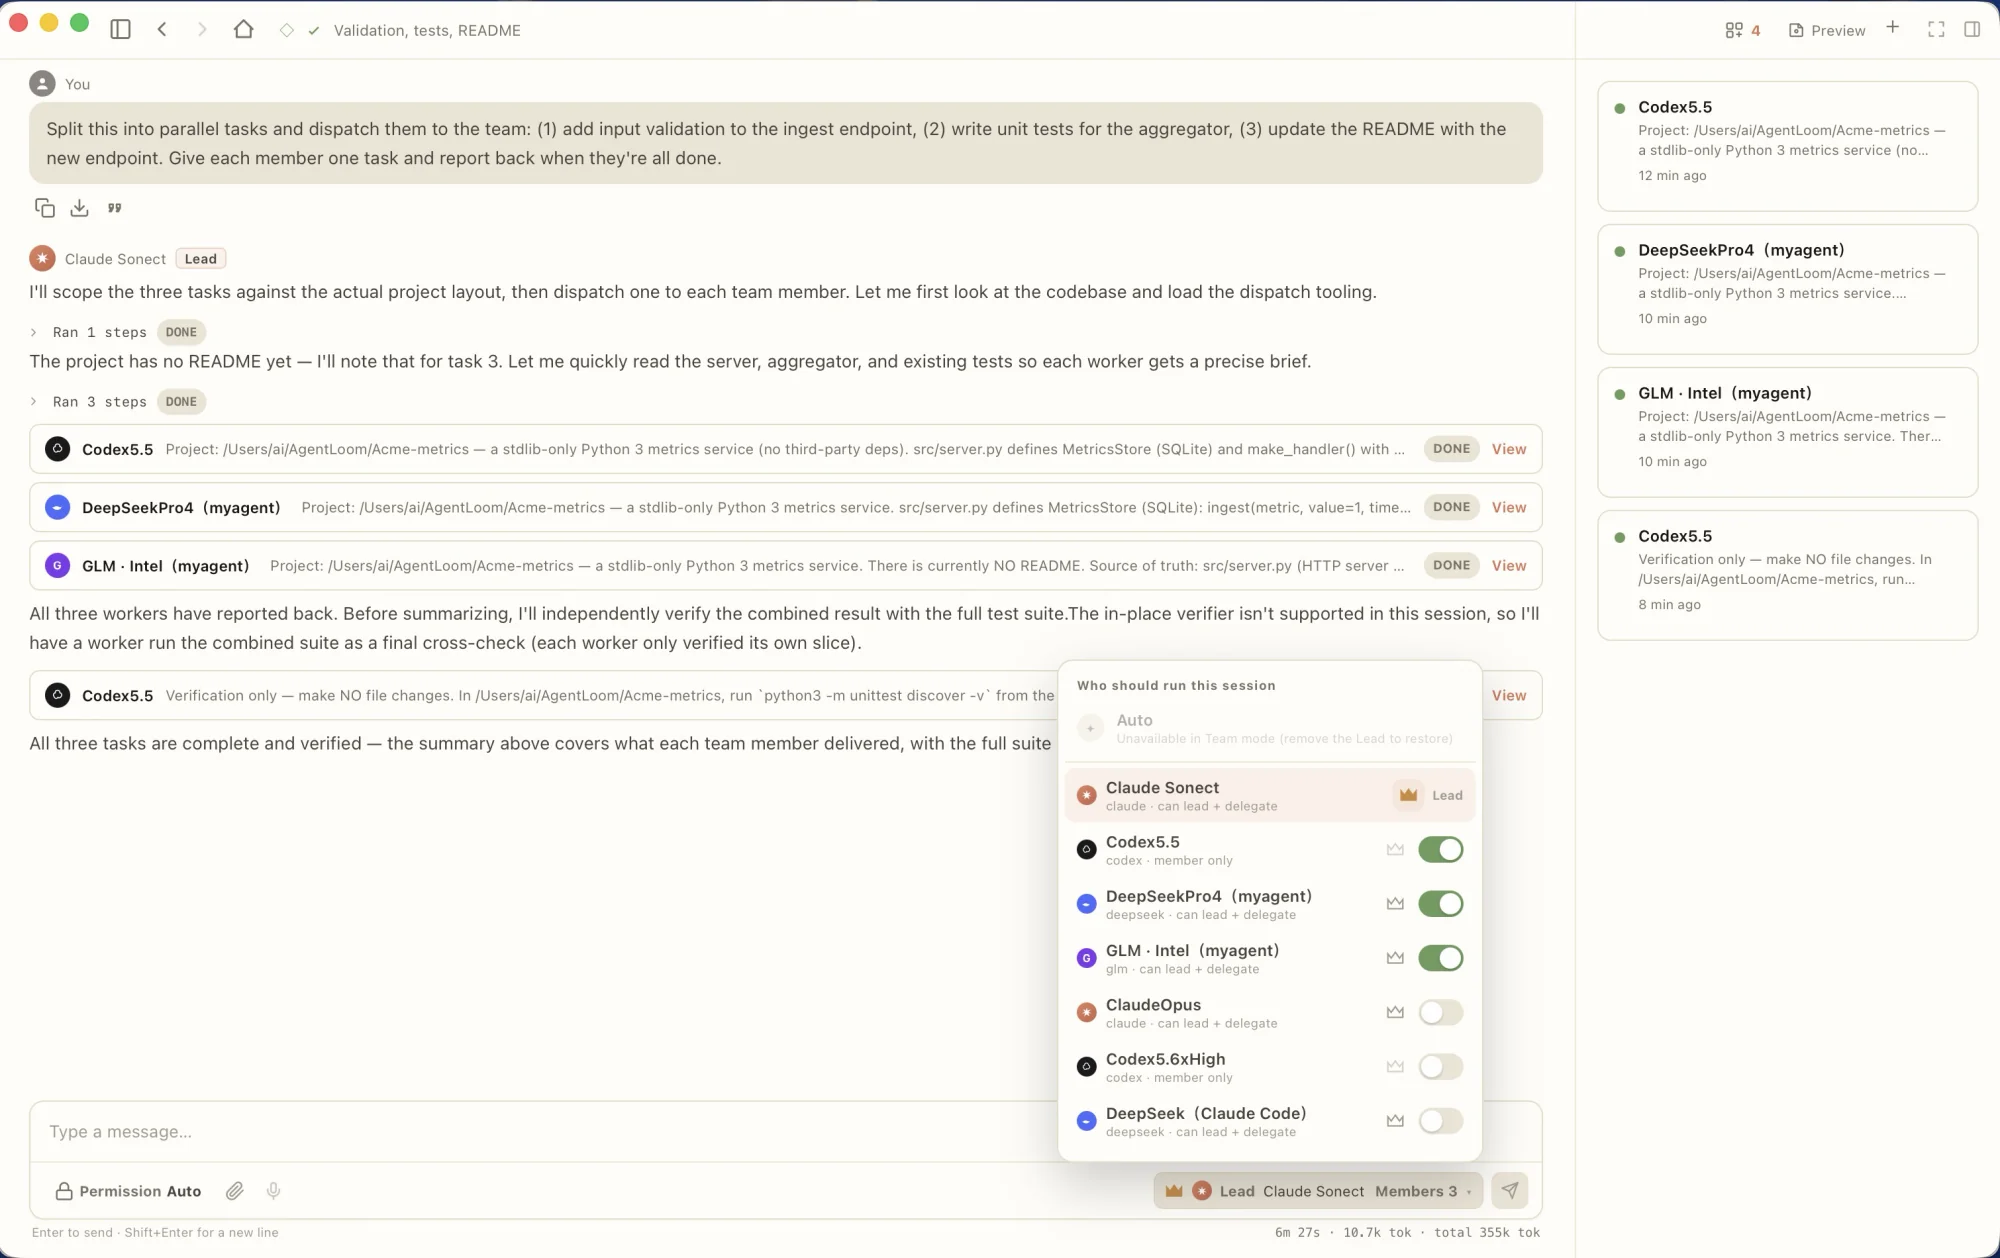
異なるモデルが、ひとつのワークスペースで力を発揮できるようにしたいと考えました。リードが目標を分解し、タスクを割り当て、結果を集めます。計画、実装、レビューには、それぞれの仕事への適性、費用、利用可能な状況に応じて異なるモデル構成を使えます。
協力には調整も必要です。担当範囲が曖昧だと編集が重複し、個々のタスクが完了しても全体が成功したとは限りません。誰が何を担当し、どんな結果が出たかを見えるようにし、統合後に確認する仕組みが必要です。
異なるモデルで、ひとつの目標へ
リードが作業を割り当て、結果を集め、検証を進める
目標を分解し、担当範囲を定める
タスクごとにモデルを選ぶ
変更と結果を確認する
役割の概要です。モデルの選択はタスクと設定によって変わり、モデルの能力を固定的に順位付けするものではありません。
02 / モデルを切り替えても、仕事を続ける
モデルの利用枠を使い切っても、同じセッション内でプロバイダーを切り替え、それまでの文脈を使って続けられます。取り組む対象は、まだ終わっていないタスクのままです。
これとは別に、引き継ぎ文書を作成して関連付けた子セッションを始める継続の仕組みもあります。両者は異なる使い方です。モデルによって文脈の解釈は変わり得るため、継続には文脈と状態を明示的に管理する必要があります。
03 / なぜ MyAgent をつくったのか
自分なりに理解した Agent の構造が、実際に動くシステムとして成り立つか試したいと考えました。また、Claude Code や Codex のような CLI エージェントをインストールしていない人でも、モデルの API キーがあれば AgentLoom を使えるようにしたいと思いました。
将来のプロダクトにも使える、自分で理解し、制御し、調整できるエンジンが欲しかったのです。その分、モデルへの対応、ツール実行、文脈の管理、検証まで、自分で責任を持つことになりました。
ワークスペースとエンジン
タスク、セッション、結果の確認
外部の CLI エージェント、または MyAgent
文脈を読み取り、行動を提案する
実行し、結果を確認する
04 / 席を離れても、状況を把握して操作する
タスクには時間がかかりますが、その間ずっと机に向かっていたいわけではありません。Remote Control なら QR コードでスマートフォンのブラウザーをペアリングし、VPN を設定せずにセッションの確認、メッセージ送信、手順の承認、作業の停止ができます。
作業を実行するのは引き続きデスクトップで、オンラインのままにする必要があります。中継サーバーが異なるネットワークの端末をつなぎ、エンドツーエンド暗号化された内容を転送しますが、接続メタデータは扱います。利便性、操作権、ネットワークの境界を一緒に考えています。
席を離れても、作業はあなたの PC で。
QR で接続し、送信・承認・停止
エンドツーエンド暗号化された内容を転送
ローカルのワークスペースでタスクを実行
両方の端末から中継サーバーへ接続するため、VPN の設定は不要です。デスクトップはオンラインである必要があります。接続メタデータは内容の暗号化の対象外です。矢印は経路を示し、通信は双方向です。
05 / 作業が終わったと、どう判断するか
同じ実行環境でも、モデルによって振る舞いは異なります。情報を多く集めるモデルも、早く行動するモデルもあります。実際のタスクを通して、いつツールや文脈を調整すべきか、いつ結果をもっと明確に検証すべきかを学びました。
モデルの完了メッセージは、結果を確認するきっかけです。ツール呼び出しの成功や不十分な自己テストだけでは、ユーザーの問題が解決したとは言えません。受け入れの判断は、元のタスクと確認できる成果に立ち返る必要があります。
評価結果をどう読むか
内部記録では、SWE-bench Verified から手動で選んだ 30 タスクを、異なるエンジンのビルドで計 8 回実行し、中央値は 17/30 でした。全 500 タスクの結果でも、固定したビルドを 8 回再実行した結果でもありません。特定の実験での振る舞いを理解するための結果であり、ベンチマーク全体の順位や実利用での普及を示すものではありません。
現在のプロダクトにつながったこと
AgentLoom はダウンロード可能で、私自身の日々の仕事にも使っています。MyAgent は後に LoomVoice のバックグラウンド処理にも再利用しました。これは具体的な成果です。一方、より多くの人が使えるよう、導入を簡単にする課題は残っています。