不同模型在规划、实现和评审中的表现并不相同,但把它们放在几个互不相通的工具里,很难围绕同一个目标协作。AgentLoom 从这个问题出发,也处理额度耗尽、上下文接续和离开电脑后的控制需求;先用编码任务验证,再面向更广泛的工作。
01 / 让适合的模型承担适合的任务
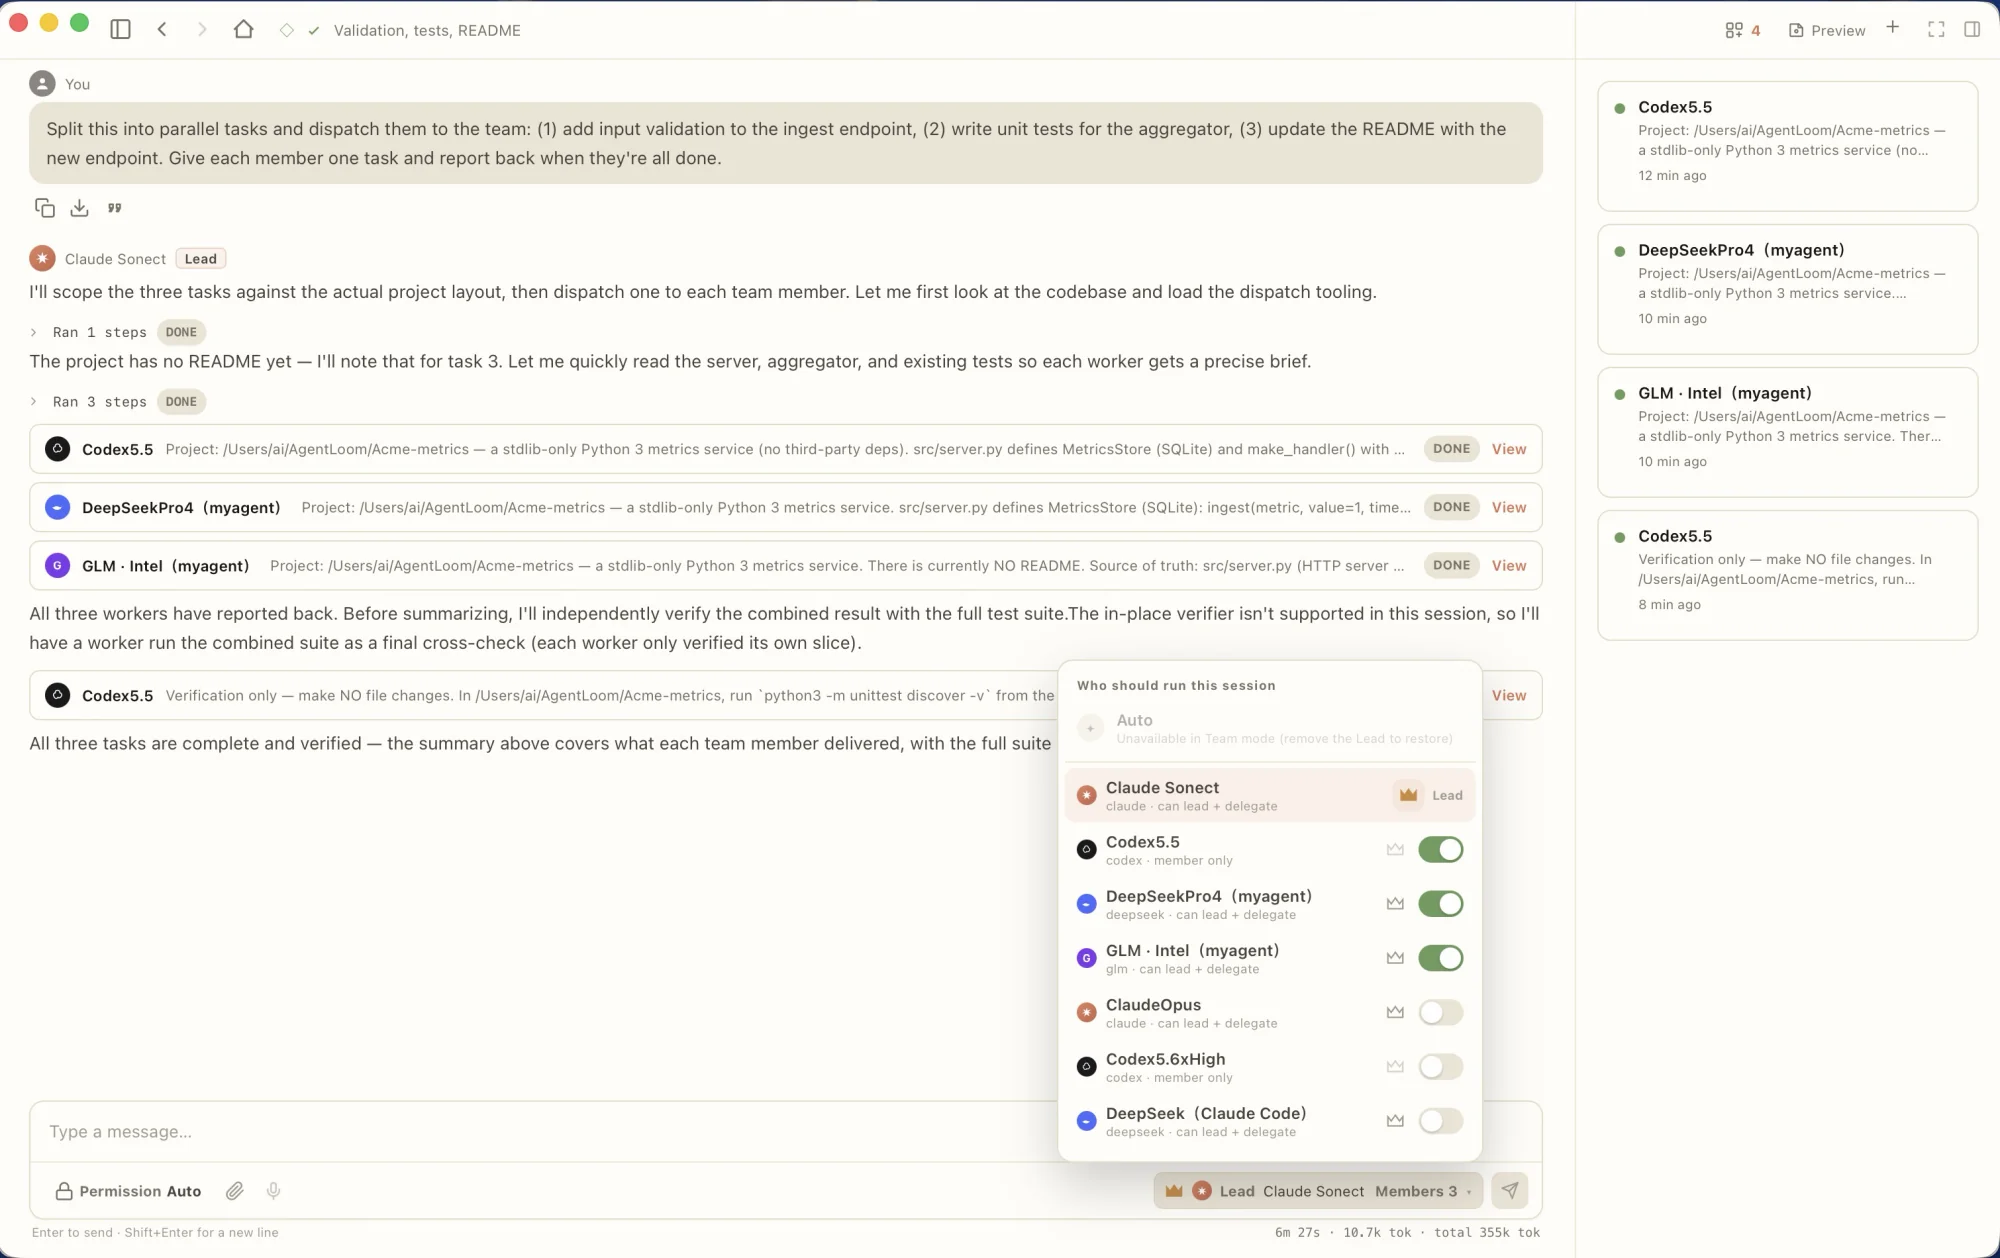
我希望把不同模型的长处放进同一平台:由 Lead 拆分目标、分派任务并收集结果。规划、实现和评审可以采用不同模型配置,选择依据是任务表现、成本与可用性。
协作也有成本:任务边界不清会造成重复修改,子任务完成也不代表整体通过。工作台必须让分工和结果可见,并保留汇总后的检查。
让不同模型围绕同一个目标分工
Lead 分配任务、收集结果并组织检查
拆分目标,明确边界
按子任务选择模型
检查改动和运行结果
角色分工示意。模型由任务需要与用户配置决定;没有固定“某模型永远最擅长某领域”的排名。
02 / 让任务跨模型继续
当某个模型额度用完,用户可以在同一会话中切换到仍有额度的 provider,延续已有上下文处理任务。这个选择把关注点从某个工具,移回了尚未完成的工作。
另一种接续方式是生成交接文档,再启动关联子会话。两种机制分别描述:切换后模型的理解和行为仍可能不同,接续也需要管理上下文与状态。
03 / 为什么自己做 MyAgent
我想通过实际构建,检验自己对 Agent 架构的理解是否足以支撑一个可运行的系统。同时,我希望用户即使没有安装 Claude Code 或 Codex 等 CLI Agent,也能通过配置模型 API key 使用 AgentLoom。
更长远地说,我希望后续产品有一个自己能够理解、掌控和定制的引擎。代价也很具体:模型适配、工具执行、上下文与验证,都变成了需要自己持续承担的工程工作。
工作台与引擎的边界
任务、会话与结果呈现
外部 CLI Agent 或 MyAgent
理解上下文,提出行动
执行并核对结果
04 / 离开电脑,也能掌握正在做的事
任务需要时间,但我不想一直守着电脑。Remote Control 让手机浏览器通过扫码配对,查看会话、补充消息、批准某一步或停止任务,无需先组建 VPN。
任务仍在桌面执行,桌面需要在线。远程连接用中继解决跨网络访问,内容端到端加密;中继仍处理连接元数据。这是便利性、控制权和网络边界一起设计的结果。
离开电脑,工作仍在自己的电脑上
扫码配对;发消息、批准或停止
转发端到端加密内容
执行任务,保留本地工作空间
双方通过出站连接接入中继,无需组建 VPN。桌面须在线;连接元数据不在内容加密范围内。箭头表示连接路径,通信是双向的。
05 / 怎样判断工作完成
不同模型在相同执行环境里,表现出不同的行动习惯。有的反复收集信息,有的更快开始修改。通过实际任务,我逐步学习哪些问题需要调整工具与上下文,哪些结果需要更明确的检查。
模型报告完成,是继续检查的一个信号。工具调用成功和简单自测通过,也不能自动证明用户的问题已经解决。实现后的验收,需要回到具体任务和可观察的结果。
评测材料怎样阅读
内部材料记录了 SWE-bench Verified 中手选 30 题子集上的八轮实验,跨越不同引擎构建,中位数为 17/30。它不是完整 500 题成绩,也不是冻结版本的八次复跑。这些结果用于理解具体实验中的行为,不能推导为整体榜单表现或真实用户规模。
今天的结果与接下来的问题
AgentLoom 已提供公开下载,也用于我的日常工作。MyAgent 后来被用于 LoomVoice 的后台任务。这个复用是一个具体结果;面向更多普通用户的配置体验,仍需要继续打磨。